sábado, 14 de abril de 2012

Executando um processo no modo Preview

Executar um processo no modo Preview permite que o usuário visualize quais registros (dados) estão passando por cada step de nosso ETL.
O modo Preview só está disponível para as transformations, ou seja, só podemos ver os dados que estão trafegando durante a execução de uma transformation, e não de um job.
O modo Preview é executado pelo botão 

Ao executarmos a transformation neste modo, precisamos definir em qual step a execução será interrompida e os dados serão exibidos, o que fica claro através da figura abaixo.


Note pela figura acima que, antes de executarmos o preview, selecionamos o step Select Values.  Além disso, o campo Number of rows to retrieve está preenchido com o número 1000.    Isto indica que queremos visualizar as 1000 primeiras linhas que passarem pelo step Select Values, e apenas após a visualização destas poderemos decidir entre visualizar os próximos mil registros ou parar o preview.
Caso tenhamos executado o preview sem selecionar um step específico, poderemos fazê-lo selecionando um dos steps na lista à esquerda da janela.

Observe também que é possível definir uma outra condição de pausa, além do número de linhas.    Se marcarmos o checkbox “Pause transformation on condition”, poderemos definir uma ou mais condições onde nosso processo será interrompido, seguindo o mesmo padrão de condições do step “Filter Rows”, cujo funcionamento já foi visto em nosso blog.

Caso a execução de nosso ETL dependa de variáveis, parâmetros ou argumentos que são provenientes de um job ou de outra transformation, podemos definir valores para estes parâmetros/variáveis/argumentos clicando no botão “Configure”.

Ao apertarmos o botão “Configure”, a mesma janela do modo de execução “Run”, que é a execução normal do ETL, será exibida.   A figura abaixo nos mostra exatamente onde preencheremos estes valores, caso sejam necessários.


Tendo em vista estes conceitos, podemos realizar testes com mais eficiência, encontrar problemas e prever diversas situações ao enxergamos com facilidade os dados que estão trafegando em um determinado momento (específico) de nosso processo.

segunda-feira, 2 de abril de 2012

Get System Info

Este é um step da categoria de "Input", que nos ajuda a recuperar algumas informações do sistema, tais como a data do sistema, o primeiro e último dia do mês, o nome de uma transformation existente, o hostname e ip da máquina, além de dezenas de outras informações que podem ser inseridas rapidamente no fluxo.

Além disso, podemos receber um valor externo ao PDI.   Particularmente, costumo utilizar bastante o tipo "command line argument" para receber um ou mais parâmetros de uma xaction, e executar o processo de ETL recebendo estes valores externos dinamicamente.

Sabendo que é possível, por exemplo, utilizar um ETL para gerar um resultado para um relatório criado no Pentaho Report Designer, podemos receber parâmetros que seriam os filtros a serem utilizados em um select, ou qualquer outro valor que o usuário entenda como importante e que precisará ser considerado na execução do job ou da transformation.

A coluna “Name” define o nome que será dado ao valor recebido ou extraído do sistema, enquanto a coluna Type define o tipo de informação que será extraída do sistema.


Como temos dezenas de tipos de informações disponíveis na coluna Type, sugiro que acessem o endereço  http://wiki.pentaho.com/display/EAI/Get+System+Info  para que entendam melhor a função de cada um.

Tendo uma boa compreensão do funcionamento deste step, estaremos dando um importante passo na utilização conjunta das diversas ferramentas da suíte Pentaho de BI, já que é muito interessante a integração que é possível realizar com estas ferramentas.

sábado, 4 de fevereiro de 2012

Excel Input

O armazenamento de dados em planilhas do Excel é muito comum e muito importante em diversas situações.    Através do componente Excel Input, podemos manipular os dados gravados nestas planilhas, aproveitando inclusive o título das colunas, caso existam.
Observe abaixo as opções do componente:


Aba Files:
Começaremos pela primeira aba, a aba Files.
Nesta aba selecionaremos os arquivos que serão processados.   Poderemos escolher um ou mais arquivos diretamente do diretório onde se encontram, ou o nome / caminho do arquivo podem chegar através de um parâmetro ou campo.
Quando os arquivos forem escolhidos, os mesmos aparecerão na coluna File/Directory.    Na coluna Wildcard(RegExp), poderemos colocar uma expressão regular que valide os arquivos que queremos importar.


Se desejarmos receber o nome de um arquivo por meio de um campo do fluxo, marcaremos a opção “Accept filenames from previous step”, selecionaremos o step que está ligado ao Excel Input e definiremos o campo que possui o nome/caminho do(s) arquivo(s).
Após determinar os arquivos e pastas, poderemos ver os que fazem parte de nossa seleção através do botão “Show filename(s)...”


Aba Sheets:
Na aba Sheets, definiremos quais planilhas entre os arquivos selecionados usaremos para extrair os registros e inseri-los ao fluxo.

Aba Contents (Conteúdo):
Na aba Content, definiremos outras opções, entre elas:
  • Header: se o cabeçalho das colunas será inserido ao fluxo;
  • No empty rows: se linhas vazias entrarão no fluxo;
  • Stop on empty row: para o processo caso encontre uma linha vazia;
  • Limit: limite de linhas que entrará no fluxo;
  • Spread sheet type: formato do arquivo que contém a(s) planilha(s), ou seja, xls, xlsx ou ods.


Aba Error Handling:
A aba Error Handling possui algumas opções para o caso de incidência de erros durante o processamento deste step.   Através das opções disponíveis, podemos decidir qual ação o fluxo deverá tomar caso haja um erro originado especificamente por este step.


Aba Fields:

Na aba Fields, escolheremos entre os campos das planilhas selecionadas aqueles que entrarão no fluxo.   Ao definirmos os campos, poderemos escolher os tipos, tamanho, precisão, formato, etc.
Observe a figura abaixo e perceba que através do botão “Get fields from header row...” podemos adicionar todas as colunas das planilhas automaticamente, sem necessidade de digitá-los um por um.


segunda-feira, 23 de janeiro de 2012

Text File Input

O step Text File Input é utilizado para ler diversos tipos de arquivos texto.    O formato mais comum entre eles é o Comma Separated Values (CSV).   Caso o arquivo texto tenha qualquer outra extensão, será necessário que o mesmo possua campos de tamanho fixo.

Este componente, assim como o Excel Input, permite que o usuário selecione uma lista de arquivos a serem lidos, ou uma lista de diretórios de onde serão lidos os arquivos, podendo ou não obedecer uma expressão regular.      Além disso, o step também poderá receber diretórios ou nomes de arquivos provenientes de steps anteriores, seja por variável, seja por um campo do fluxo, permitindo desta forma que o manuseio dos arquivos seja ainda mais genérico.

Veremos a seguir as opções específicas, ou seja, o diferencial deste componente em relação aos outros steps de Input.


Filetype – o usuário poderá definir entre um arquivo do tipo CSV ou um arquivo de tamanho fixo;

Separator – caso o arquivo seja do tipo CSV, é provável que você defina o separador dos campos.   Normalmente a vírgula ou o ponto-e-vírgula são mais utilizados;

Enclosure – caso os campos estejam dentro de um par de caracteres (parênteses ou aspas duplas por exemplo), o caractere deve ser definido aqui;

Escape – define o caractere que irá ignorar o caractere definido como separator, caso este seja necessário dentro do texto.
Ex:  Se o separator for uma aspas simples, e uma coluna tiver o texto ‘Gota d´água’, será necessário que o arquivo CSV venha com o texto ‘Gota d\´água’ para que o componente entenda este texto como um campo só ao invés de dois.   Neste caso, a barra serve como Escape;

Header – define se haverá um cabeçalho e quantas linhas correspondem a este cabeçalho;

Footer – segue a mesma regra do Header também para o rodapé;

No empty rows – impede que as linhas vazias sejam enviadas para o fluxo;

Include filename in output – define se o nome do arquivo também será enviado ao fluxo;

Filename field name – define o nome do campo que levará o nome do arquivo pelo fluxo;

Rownum in output – define se o número da linha no arquivo será enviada ao fluxo;

Row number field name – define o nome do campo que levará o número da linha;

Rownum by file? – define se o número das linhas será reiniciado a cada arquivo lido;

Format – formato do arquivo.    Pode ser DOS, UNIX ou mixed;

Encoding – especifica o encoding que será utilizado;

Limit – Especifica o número de linhas que serão lidas por arquivo.  0 (zero) significa a leitura de todas as linhas.

Na aba Fields, veremos mais algumas especificidades do componente.    Caso tenhamos escolhido o tipo de arquivo CSV na aba Content, basta clicar no botão “Obtém Campos” e, automaticamente, os campos identificados de acordo com o cabeçalho (Header) e divididos pelo caractere definido como Separator serão exibidos.


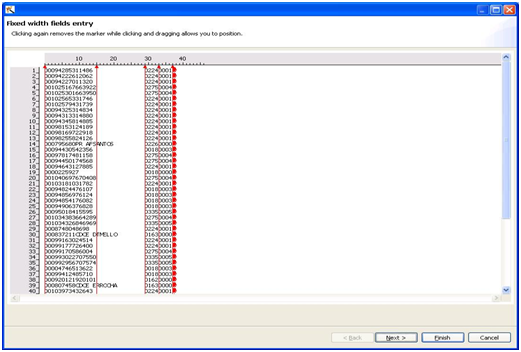
Caso o tipo de arquivo definido na aba Content seja Fixed, ao clicarmos no botão “Obtém Campos”, visualizaremos a seguinte tela:

Ao clicarmos em qualquer ponto da visualização do arquivo, definiremos a quantidade de caracteres e/ou espaços que formarão os campos.   A seta vermelha indica o limite do campo.   Para adicionar uma seta, basta clicar no ponto desejado.   Para retirar a limitação, basta clicar novamente sobre a seta.


Ao seguirmos pelo botão “Next”, definiremos o nome de cada campo que acabamos de definir.   Perceba que na parte direita da janela visualizaremos os dados do intervalo de espaço que definimos anteriormente.

sábado, 17 de dezembro de 2011

Ordenando os registros com o Sort Rows

Hoje iremos explicar sobre o componente de ordenação do Kettle.

O Sort Rows, além de sua utilidade natural, também é indispensável quando desejarmos utilizar componentes de junção (JOIN), agrupamento (GROUP BY) ou de eliminação de duplicidade (UNIQUE).
Isso acontece pela maneira que os componentes "entendem" os registros que passam pelo fluxo.
Se utilizarmos como exemplo o componente de group by, podemos dizer que primeiro precisamos organizar as linhas e juntar todas as que devem ser agrupadas, e aí sim utilizar a função de agregação (count, max, min, avg, etc).

Voltando a tratar especificamente sobre o step "Sort Rows", vamos ao preenchimento dos campos:


Como o Kettle precisa ordenar as linhas utilizando arquivos temporários quando o número de linhas excede ao tamanho especificado, cujo padrão é de 5000, existem alguns campos que podem ser preenchidos quando a situação o exigir.

Sort directory: diretório onde serão gravados os arquivos temporários caso necessário.   O padrão é o diretório do sistema;
TMP-file prefix:  prefixo que será utilizado para reconhecer os arquivos temporários quando estes forem exibidos no diretório de arquivos temporários;
Sort Size: número de linhas que serão gravadas na memória.   Quanto mais, melhor;
Free memory threshold (in %):  Se o algoritmo de ordenação achar que existe menos memória livre disponível que o indicado, começará a paginar os dados no disco;
Compress TMP Files:   compacta os arquivos temporários quando estes forem necessários para completar a ordenação.

Apesar de úteis, os itens acima são pouco utilizados e normalmente não os alteramos.   Os itens que precisamos nos concentrar são os seguintes:

Only pass unique rows:   linhas duplicadas serão retiradas do fluxo após a ordenação;
Fieldname:  campo(s) que será(ão) ordenados;
Ascending:   ordenação de forma ascendente ou descendente;
Case sensitive compare:   se será case sensitive (maiúsculas e minúsculas);
Get Fields:  coloca na lista de fieldnames todos os campos que estão passando pelo fluxo.

Lembrando que o Sort Rows, semelhante ao comando order by do SQL, poderá ordenar campos do tipo integer, string, date, entre outros.   Quando desejar utilizar os componente de junção, agregação ou de eliminação de duplicidade, certifique-se sempre de que os dados que estão passando pelo fluxo estão corretamente ordenados, seja pelo step Sort Rows ou pela própria query que originou os dados.

sexta-feira, 11 de novembro de 2011

Movimentação de Dados

Quando estamos trabalhando com os dados em nosso fluxo, é comum termos dois ou mais destinos para um determinado step.    
Um exemplo mais óbvio disso é quando queremos que os dados sejam gravados em uma tabela e também em uma planilha do Excel.   Ou quando queremos garantir que metade das linhas sejam gravadas em um destino, enquanto a outra metade seguirá por outro caminho.  A mesma divisão pode ser feita em três, quatro ou diversos steps.
No primeiro exemplo, precisaremos copiar os dados para os dois destinos.    No segundo exemplo, precisaremos distribuir (dividir) os dados.

E como faremos isto?
Esta é mais uma dica simples, para facilitar a vida daqueles que estão começando a trabalhar com a ferramenta.
Para definir como será o destino dos dados de um determinado step, podemos clicar neste step com o botão direito e selecionar a opção "Movimento de dados", conforme mostra a figura abaixo:


Quando escolhermos a opção de "Distribuir os dados para os próximos steps", caso tenhamos 100 linhas em nosso fluxo e dois steps de destino, teremos 50 linhas seguindo para um destino e 50 para outro.   Se tivermos 3 destinos, teremos 33, 33 e 34, e assim por diante.
Importante destacar que a divisão NÃO é feita de forma ordenada, ou seja, o primeiro destino NÃO receberá as primeiras 50 linhas (registros) se dividirmos o fluxo em dois destinos.    Caso desejemos dividir desta forma, precisaremos utilizar outros componentes para este controle, como o Filter Rows ou Switch/Case, por exemplo.

Se escolhermos a opção "Copia dados para os próximos steps", utilizando o exemplo das 100 linhas (registros), todos os 100 registros serão copiados para TODOS os destinos, independente de quantos sejam.
A figura abaixo mostra como podemos identificar o movimento de dados de um step através do hop.   No modo de distribuição, o hop mostrará a penas uma seta.   No modo de cópia, um iconezinho de cópia ficará desenhado sobre o hop.


Quando estivermos modelando nosso fluxo e apontarmos dois hops saindo do mesmo step para dois destinos diferentes, o próprio Kettle já solicitará esta informação, ou seja, perguntará qual será o tipo de movimentação de dados, indicando que o movimento padrão é o de cópia.


Com estas informações, poderemos trabalhar melhor com fluxos mais complexos, principalmente aqueles que possuem condições de tráfego, vários destinos ou um tratamento mais sofisticado.    Lembre-se que o componente Filter Rows (objeto de nosso último post), que divide os dados de acordo com uma condição definida (IF-ELSE), obviamente deve distribuir os dados.

quarta-feira, 2 de novembro de 2011

Filter Rows

Veremos hoje como utilizar o componente Filter Rows.  Para deixar claro a sua utilidade, poderíamos compará-lo ao comando IF-THEN-ELSE, já que através de uma comparação simples, o step direcionará o registro entre duas opções de destino.

Para começar, arraste o step Filter Rows da pasta Flow (no menu à esquerda) para a área de trabalho do Kettle, na parte do fluxo que desejar.
Observe pelo exemplo abaixo que estamos utilizando este step para filtrar os registros e, dependendo do resultado, o fluxo descartará as linhas indesejadas.
Neste cenário, ainda não definimos a comparação que será feita.


Vamos definir então as condições de continuidade do fluxo.    Usaremos como exemplo a coluna qtd, que significa a quantidade de vendas de um determinado funcionário.   Se a quantidade de vendas de um produto for maior do que 5, os registros continuarão no fluxo, do contrário, irão para o step Descarta.


Perceba que agora os hops (setas de indicação de fluxo) mudaram da cor preta para as cores verde e vermelha.   O hop de cor verde indica a condição true, enquanto o hop de cor vermelha indica a condição false.


Se quisermos incrementar nossa comparação, comparando outros campos (literalmente um if-then-else), basta clicar no botão Add Condition  

Com este botão, você terá acesso aos operadores AND, OR, OR NOT, AND NOT e XOR.
Assim, podemos mudar nossa condição do fluxo, para linhas que tiverem a qtd > 5 AND id_funcionario <= 300.    Esta condição indica que manteremos os registros entre os funcionários com id <= 300 e os produtos que tiveram mais de 5 vendas.    Apenas se as duas condições forem satisfeitas é que o registro continuará pelo fluxo no caminho indicado pela condição true.


Perceba que este componente pode ser considerado também como a cláusula WHERE do SQL.   Esta percepção é importante, pois notaremos que há varios componentes que representarão as cláusulas SELECT, DISTINCT, TOP, GROUP BY, ORDER BY, etc, permitindo assim que manipulemos os dados sem precisar de componentes de script, que piorariam a performance de nosso ETL.

Além deste componente, existe o Switch/Case, que será útil quando precisarmos de mais saídas além do true ou false.   A utilização deste step, que também é simples, será vista mais adiante.